فهرست مطالب
ساخت فایل robots.txt با این ابزار بدون حفظ کردن قواعد نگارشی آن انجام میشود. دسترسی پیشفرض را انتخاب کنید؛ اجازهٔ خزیدن به همهٔ رباتها، که برای تقریبا همهٔ سایتهای منتشرشده درست است، یا مسدود کردن همه، که فقط برای سایتهای در حال ساخت کاربرد دارد. مسیرهایی را که نباید خزیده شوند، هر کدام در یک خط بنویسید؛ نمونهٔ پیشفرض ابزار پنل مدیریت، سبد خرید، صفحهٔ پرداخت و نسخههای مرتبشدهٔ فهرستها را مسدود کرده است. اگر داخل مسیر مسدود، زیرمسیری هست که باید خزیده شود، آن را در بخش مسیرهای مجاز استثنا بنویسید. نشانی سایتمپ را وارد کنید و اگر میخواهید، رباتهای هوش مصنوعی را جداگانه مسدود کنید. فایل همزمان ساخته میشود و آمادهٔ کپی یا دانلود است.
راهنمای استفاده از ساخت فایل robots.txt
- دسترسی پیشفرض همهٔ رباتها را انتخاب کنید.
- مسیرهایی که نباید خزیده شوند (مثل /admin/) را هر کدام در یک خط بنویسید.
- آدرس سایتمپ و تنظیمات رباتهای هوش مصنوعی را مشخص و فایل را دانلود کنید.
robots.txt چیست و چه کاری نمیکند؟
robots.txt فایل متنی سادهای در ریشهٔ دامنه است که به رباتهای خزنده میگوید کدام بخشهای سایت را نخزند. این فایل بر اساس قراردادی قدیمی به نام پروتکل حذف رباتها کار میکند که سالها عرف بود و چند سال پیش بهصورت استاندارد رسمی اینترنتی هم منتشر شد. رباتهای معتبر، مثل گوگلبات و ربات بینگ، پیش از خزیدن هر سایت این فایل را میخوانند و قواعدش را رعایت میکنند. اگر فایل وجود نداشته باشد، رباتها فرض میکنند همهجای سایت آزاد است و این برای بیشتر سایتها کاملا مشکلی ندارد.
مهمترین چیزی که باید دربارهٔ این فایل بدانید، کاری است که نمیکند. robots.txt ابزار امنیتی نیست؛ خودش عمومی است و هر کسی میتواند آن را بخواند، پس نوشتن مسیر پنل مدیریت مخفی در آن، عملا آن مسیر را به همه معرفی میکند. رباتهای بدخواه هم آن را رعایت نمیکنند. و از همه مهمتر، robots.txt صفحه را از نتایج گوگل حذف نمیکند. این فایل جلوی خزیدن را میگیرد، نه جلوی ایندکس شدن را؛ اگر صفحهٔ مسدودی از جای دیگری لینک گرفته باشد، گوگل ممکن است نشانی آن را بدون محتوا و بدون توضیحات در نتایج نشان دهد.
Disallow یا noindex؛ پرهزینهترین اشتباه
بسیاری از صاحبان سایت برای بیرون بردن یک صفحه از گوگل، مسیرش را در robots.txt مسدود میکنند و بعد تعجب میکنند که صفحه هنوز در نتایج است. اشتباه رایجتر و بدتر این است که هم متاتگ noindex روی صفحه بگذارند و هم آن را در robots.txt مسدود کنند. در این حالت گوگل اجازهٔ خزیدن صفحه را ندارد، پس هیچوقت متاتگ noindex را نمیبیند و صفحه ممکن است برای همیشه در نتایج بماند.
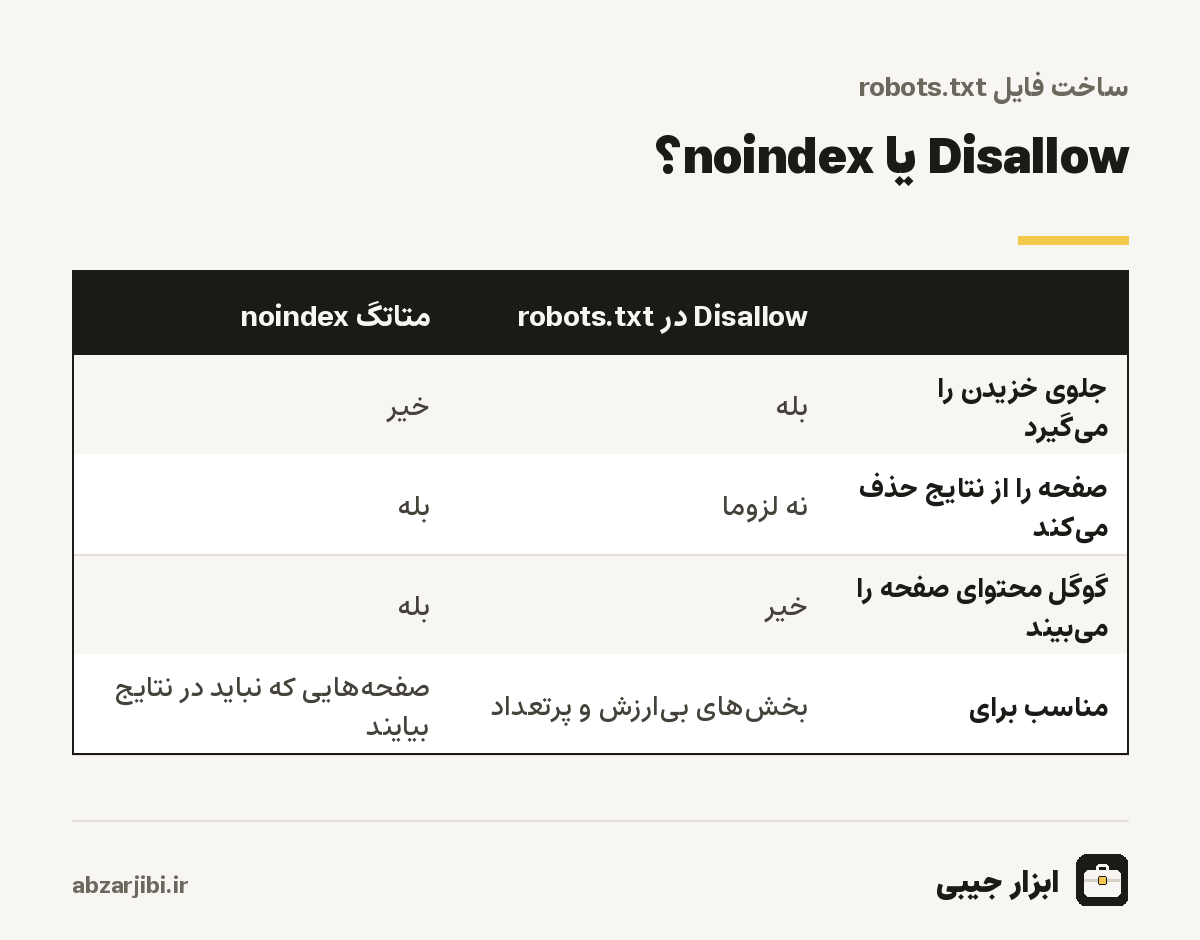
قاعدهٔ درست ساده است. اگر میخواهید صفحهای در نتایج نیاید، روی خود صفحه متاتگ noindex بگذارید و آن را در robots.txt آزاد بگذارید تا گوگل بتواند بخزد و دستور را ببیند. پس از اینکه صفحه از نتایج بیرون رفت، اگر خواستید میتوانید مسیرش را مسدود کنید. robots.txt را برای بخشهایی نگه دارید که خزیدنشان بیفایده و پرهزینه است؛ مثل صفحههای نتایج جستوجوی داخلی، نسخههای بیشمار فهرست محصولات با ترکیبهای مختلف فیلتر و مرتبسازی، سبد خرید و پنل کاربری. متاتگ noindex را با ساخت متا تگ میتوانید بسازید.
ساخت فایل robots.txt؛ قواعد نگارش
فایل از چند گروه تشکیل میشود. هر گروه با خط User-agent شروع میشود که نام رباتی را که قواعد برایش است مشخص میکند و ستاره یعنی همهٔ رباتها. بعد از آن خطهای Disallow و Allow میآیند که هر کدام یک مسیر دارند. خط Sitemap مستقل از گروههاست و نشانی کامل سایتمپ را اعلام میکند. ابزار همهٔ اینها را با ترتیب و قالب درست مینویسد و اگر مسیری را بدون خط مورب ابتدایی بنویسید، خودش آن را اضافه میکند.
| دستور | معنا | نمونه |
|---|---|---|
| User-agent: * | قواعد بعدی برای همهٔ رباتها | گروه اصلی فایل |
| Disallow: /admin/ | پوشهٔ مدیریت و همهٔ زیرمسیرهایش را نخز | پنل مدیریت |
| Disallow: /*?sort= | هر نشانی که پارامتر مرتبسازی دارد را نخز | فهرستهای مرتبشده |
| Disallow: /*.pdf$ | نشانیهایی که به پسوند پیدیاف ختم میشوند | فایلهای پیدیاف |
| Allow: /admin/help/ | استثنا داخل مسیر مسدود | راهنمای عمومی |
| Disallow: | خط خالی یعنی هیچچیز مسدود نیست | آزادی کامل |
| Sitemap: | نشانی کامل سایتمپ | معرفی نقشهٔ سایت |
دو نویسه در مسیرها معنای ویژه دارند و گوگل و بینگ هر دو آنها را میفهمند. ستاره یعنی هر دنبالهای از نویسهها و علامت دلار در انتهای مسیر یعنی نشانی همینجا تمام میشود. مسیرها به بزرگی و کوچکی حروف حساساند؛ مسیر مدیریت با حرف بزرگ و کوچک، دو مسیر متفاوتاند. هر مسیری که با ابتدای نشانی جور شود، شامل قاعده است؛ یعنی Disallow برای مسیر مدیریت، همهٔ صفحههای زیر آن را هم مسدود میکند.
وقتی دو قاعده با هم تعارض دارند
ممکن است یک نشانی هم با یک خط Disallow جور شود و هم با یک خط Allow. گوگل در این حالت به ترتیب خطها در فایل اهمیتی نمیدهد؛ قاعدهای را اجرا میکند که مسیرش طولانیتر و دقیقتر است. اگر طول دو مسیر برابر باشد، قاعدهٔ کمتر محدودکننده، یعنی Allow، برنده است. به همین دلیل است که میتوانید کل پوشهای را مسدود کنید و یک زیرپوشهٔ آن را با Allow آزاد بگذارید؛ مسیر زیرپوشه طولانیتر است و برنده میشود.
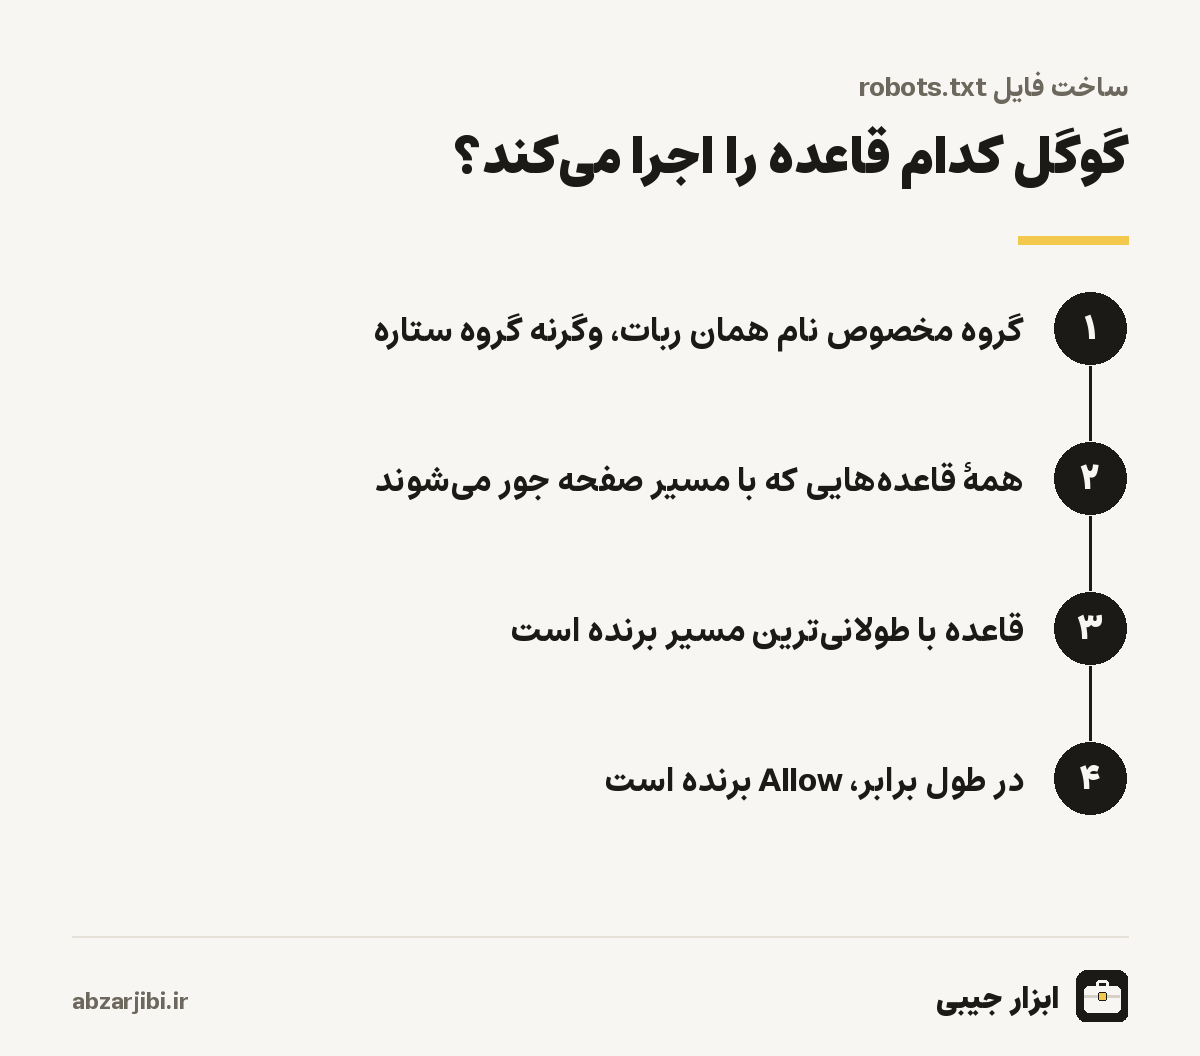
نکتهٔ دیگری که کمتر کسی به آن توجه دارد، رابطهٔ گروههاست. هر ربات فقط از یک گروه پیروی میکند؛ گروهی که نام خودش را دارد و اگر چنین گروهی نبود، گروه ستاره. یعنی اگر برای گوگلبات گروه جداگانهای بنویسید، گوگلبات قواعد گروه ستاره را دیگر نمیخواند و فقط قواعد گروه خودش را اجرا میکند. اگر میخواهید قاعدهای برای همه و قاعدهٔ اضافهای برای یک ربات خاص داشته باشید، قواعد عمومی را در گروه آن ربات هم تکرار کنید. ابزار برای رباتهای هوش مصنوعی گروه جداگانهای میسازد که کل سایت را مسدود میکند، پس این موضوع آنجا مشکلی ایجاد نمیکند.
رباتهای هوش مصنوعی؛ مسدود کنیم یا نه؟
در سالهای اخیر، شرکتهای هوش مصنوعی رباتهایی ساختهاند که محتوای وب را برای آموزش مدلها یا پاسخ دادن به پرسش کاربران جمع میکنند. ابزار شش مورد شناختهشده را با یک تیک قابل مسدود کردن کرده است. GPTBot ربات شرکت اوپنایآی است، ClaudeBot ربات شرکت آنتروپیک، CCBot ربات پروژهٔ کامن کرال که دادههایش را بسیاری از سازندگان مدل استفاده میکنند، PerplexityBot ربات موتور پاسخگوی پرپلکسیتی و Bytespider ربات شرکت بایتدنس. Google-Extended ربات جداگانهای نیست، بلکه نامی است که گوگل برای کنترل استفاده از محتوای سایت در مدلهای هوش مصنوعی خودش تعریف کرده است.
مسدود کردن Google-Extended روی حضور سایت در جستوجوی گوگل اثری ندارد و گوگلبات همچنان سایت را برای نتایج جستوجو میخزد. اما توجه کنید که خلاصههای هوش مصنوعی بالای نتایج جستوجوی گوگل بخشی از خود جستوجو هستند و با این نام کنترل نمیشوند. تصمیم دربارهٔ بقیهٔ رباتها به اولویتهای شما بستگی دارد. ناشری که محتوای اختصاصی و پرهزینه تولید میکند، ممکن است نخواهد بدون اجازه در آموزش مدلها استفاده شود. از طرف دیگر، سایتی که میخواهد در پاسخهای دستیارهای هوش مصنوعی دیده و به آن ارجاع داده شود، با مسدود کردن همهچیز این فرصت را از دست میدهد. برخی شرکتها برای جستوجوی زنده و برای آموزش، رباتهای جداگانه دارند؛ پیش از تصمیم، مستندات هر شرکت را ببینید.
نمونهٔ فایل برای یک فروشگاه اینترنتی
مقادیر پیشفرض ابزار برای فروشگاههای اینترنتی انتخاب شدهاند و بد نیست ببینید هر خط چرا آنجاست. پنل مدیریت مسدود است، چون هیچ صفحهٔ آن ارزشی برای نتایج جستوجو ندارد و فقط صفحهٔ ورود را نشان میدهد. سبد خرید و صفحهٔ پرداخت مسدودند، چون برای هر کاربر متفاوتاند و خزیدنشان فقط بار سرور را زیاد میکند. خط چهارم هر نشانیای را که پارامتر مرتبسازی دارد مسدود میکند؛ فهرست محصولات یک دسته ممکن است به ده شکل مختلف مرتب شود و هر کدام برای خزنده یک نشانی جداگانه است، در حالی که محتوایشان یکی است.
فروشگاههای بزرگتر معمولا پارامترهای فیلتر را هم به همین شکل اضافه میکنند؛ فیلتر رنگ، اندازه، برند و بازهٔ قیمت. ترکیب این فیلترها میتواند هزاران نشانی بسازد که هیچکدام برای جستوجو ارزشی ندارند و خزنده وقتش را صرف آنها میکند به جای صفحههای محصول. اما اگر برخی صفحههای فیلترشده برایتان مهماند، مثلا صفحهٔ کفش ورزشی یک برند خاص که جستوجوی زیادی دارد، آنها را مسدود نکنید و به جایش برایشان نشانی تمیز و ثابت بسازید. صفحههای نتایج جستوجوی داخلی سایت هم جزو مواردیاند که گوگل صریحا توصیه میکند از خزیدنشان جلوگیری شود.
آزمایش پیش از انتشار
پیش از جایگزین کردن فایل فعلی سایت، فایل تازه را با دقت بخوانید و برای چند نشانی مهم سایت از خودتان بپرسید آیا قاعدهای آنها را مسدود میکند. صفحهٔ اصلی، یک صفحهٔ دسته، یک صفحهٔ محصول یا مقاله و فایلهای استایل و اسکریپت قالب را امتحان کنید. ستاره در مسیرها گاهی بیش از انتظار نشانیها را میگیرد؛ قاعدهای که برای پارامتر خاصی نوشتهاید، ممکن است نشانیهای دیگری را هم که همان حروف را دارند ببندد.
پس از انتشار، گزارش robots.txt در سرچ کنسول را باز کنید و ببینید گوگل نسخهٔ تازه را خوانده است. ابزار بازرسی نشانی در همان سرچ کنسول هم برای هر نشانی میگوید آیا خزیدنش مجاز است یا با robots.txt مسدود شده. اگر چند روز بعد در گزارش صفحهها دیدید تعداد صفحههای مسدودشده با robots.txt ناگهان زیاد شده، قاعدهای بیش از حد گسترده نوشتهاید و باید فورا اصلاحش کنید.
Crawl-delay و سایتمپ
دستور Crawl-delay از ربات میخواهد بین درخواستهایش چند ثانیه فاصله بگذارد. ابزار این فیلد را دارد، اما همانطور که کنار فیلد نوشته شده، گوگل این دستور را نادیده میگیرد و سرعت خزیدن را خودش بر اساس پاسخدهی سرور تنظیم میکند. برخی موتورهای دیگر مثل بینگ آن را رعایت میکنند. اگر سرور شما زیر فشار خزندههاست، این دستور میتواند برای آن موتورها مفید باشد، اما عدد بزرگ یعنی خزیدن بسیار کند سایت و دیرتر دیده شدن صفحههای تازه.
خط Sitemap نشانی کامل سایتمپ را به همهٔ موتورهای جستوجو اعلام میکند و بهترین راه برای اطمینان از اینکه موتورهایی که سایتمپ را دستی در آنها ثبت نکردهاید هم آن را پیدا کنند. نشانی باید کامل و با پروتکل باشد و اگر چند سایتمپ دارید، برای هر کدام یک خط بنویسید. اگر هنوز سایتمپ ندارید، ساخت سایت مپ آن را با خزیدن سایت میسازد.
فایل را کجا بگذاریم؟
فایل باید دقیقا با نام robots.txt و حروف کوچک، در ریشهٔ دامنه قرار بگیرد؛ همان جایی که با نشانی دامنه و نام فایل باز شود. فایلی که در پوشهٔ دیگری باشد، نادیده گرفته میشود. هر میزبان فایل خودش را میخواهد؛ زیردامنهٔ وبلاگ یا فروشگاه، فایل جداگانهای لازم دارد و فایل دامنهٔ اصلی روی آن اثری ندارد. فایل باید متن سادهٔ یونیکد باشد و گوگل فقط پانصد کیلوبایت اول آن را میخواند که برای هر سایت معقولی بیش از کافی است.
در وردپرس، اگر فایل فیزیکی در ریشه نباشد، خود وردپرس یک فایل مجازی ساده تولید میکند و افزونههای سئو هم معمولا ویرایشگری برای آن دارند. اگر فایل فیزیکی بارگذاری کنید، جایگزین فایل مجازی میشود. گوگل محتوای robots.txt را معمولا تا یک شبانهروز در حافظه نگه میدارد؛ پس تغییرات فورا اثر نمیکنند. در سرچ کنسول گوگل، گزارش robots.txt نشان میدهد گوگل آخرین بار کدام نسخه را خوانده و آیا خطایی داشته است.
اشتباههایی که سایت را از گوگل بیرون میاندازد
خطرناکترین اشتباه، جا ماندن دستور مسدود کردن همه پس از راهاندازی سایت است. بسیاری از سایتها در زمان ساخت، کل سایت را مسدود میکنند تا نسخهٔ ناقص در گوگل دیده نشود و بعد از انتشار، کسی یادش نمیماند آن را بردارد. نتیجه سایتی است که هفتهها و ماهها در گوگل دیده نمیشود. اگر در ابزار گزینهٔ مسدود کردن همه را انتخاب کنید، فایل فقط یک قاعده خواهد داشت که کل سایت را میبندد؛ این گزینه را فقط آگاهانه انتخاب کنید.
اشتباه دوم، مسدود کردن فایلهای استایل و جاوااسکریپت است. گوگل صفحه را مثل مرورگر نمایش میدهد تا بفهمد کاربر چه میبیند و اگر نتواند این فایلها را بخواند، ممکن است صفحه را ناقص یا نامناسب برای موبایل تشخیص دهد. اشتباه سوم، خطای سرور روی خود فایل robots.txt است. اگر سرور برای این فایل خطای ۴۰۴ برگرداند، گوگل فرض میکند همهچیز آزاد است؛ اما اگر خطای سرور برگرداند، گوگل از ترس خزیدن جاهای ممنوع، ممکن است خزیدن کل سایت را موقتا متوقف کند. پس از هر تغییر، فایل را در مرورگر باز کنید و مطمئن شوید درست نمایش داده میشود.
robots.txt برای سایت در حال ساخت
اگر سایتی را روی دامنهٔ عمومی میسازید و هنوز آمادهٔ انتشار نیست، گزینهٔ مسدود کردن همه در ابزار، جلوی خزیدن رباتهای معتبر را میگیرد. اما این روش کامل نیست؛ اگر کسی به سایت آزمایشی شما لینک بدهد، نشانیها ممکن است بدون محتوا در نتایج ظاهر شوند. راه مطمئنتر برای سایتهای آزمایشی، گذاشتن رمز عبور روی کل سایت در تنظیمات سرور است که هم رباتها و هم کاربران کنجکاو را بیرون نگه میدارد. در هر حال، روز انتشار، اولین کار باز کردن فایل robots.txt سایت و اطمینان از برداشتن قاعدهٔ مسدودسازی کامل است؛ آن را در فهرست کارهای روز راهاندازی بنویسید.
ابزارهای مرتبط
برای دادهٔ ساختاریافتهٔ صفحهها، ساخت اسکیما را ببینید و اگر نشانیهای سایت فارسیاند و میخواهید آنها را در فایل به شکل کدگذاریشده بنویسید، رمزگشایی URL کمک میکند. برای کارهای فنی دیگر سایت، سری به ابزارهای سئو بزنید.
آخرین بازبینی محتوا: · تیم تحریریه ابزار جیبی